
Por Agustino Fontevecchia, Project Syndicate.
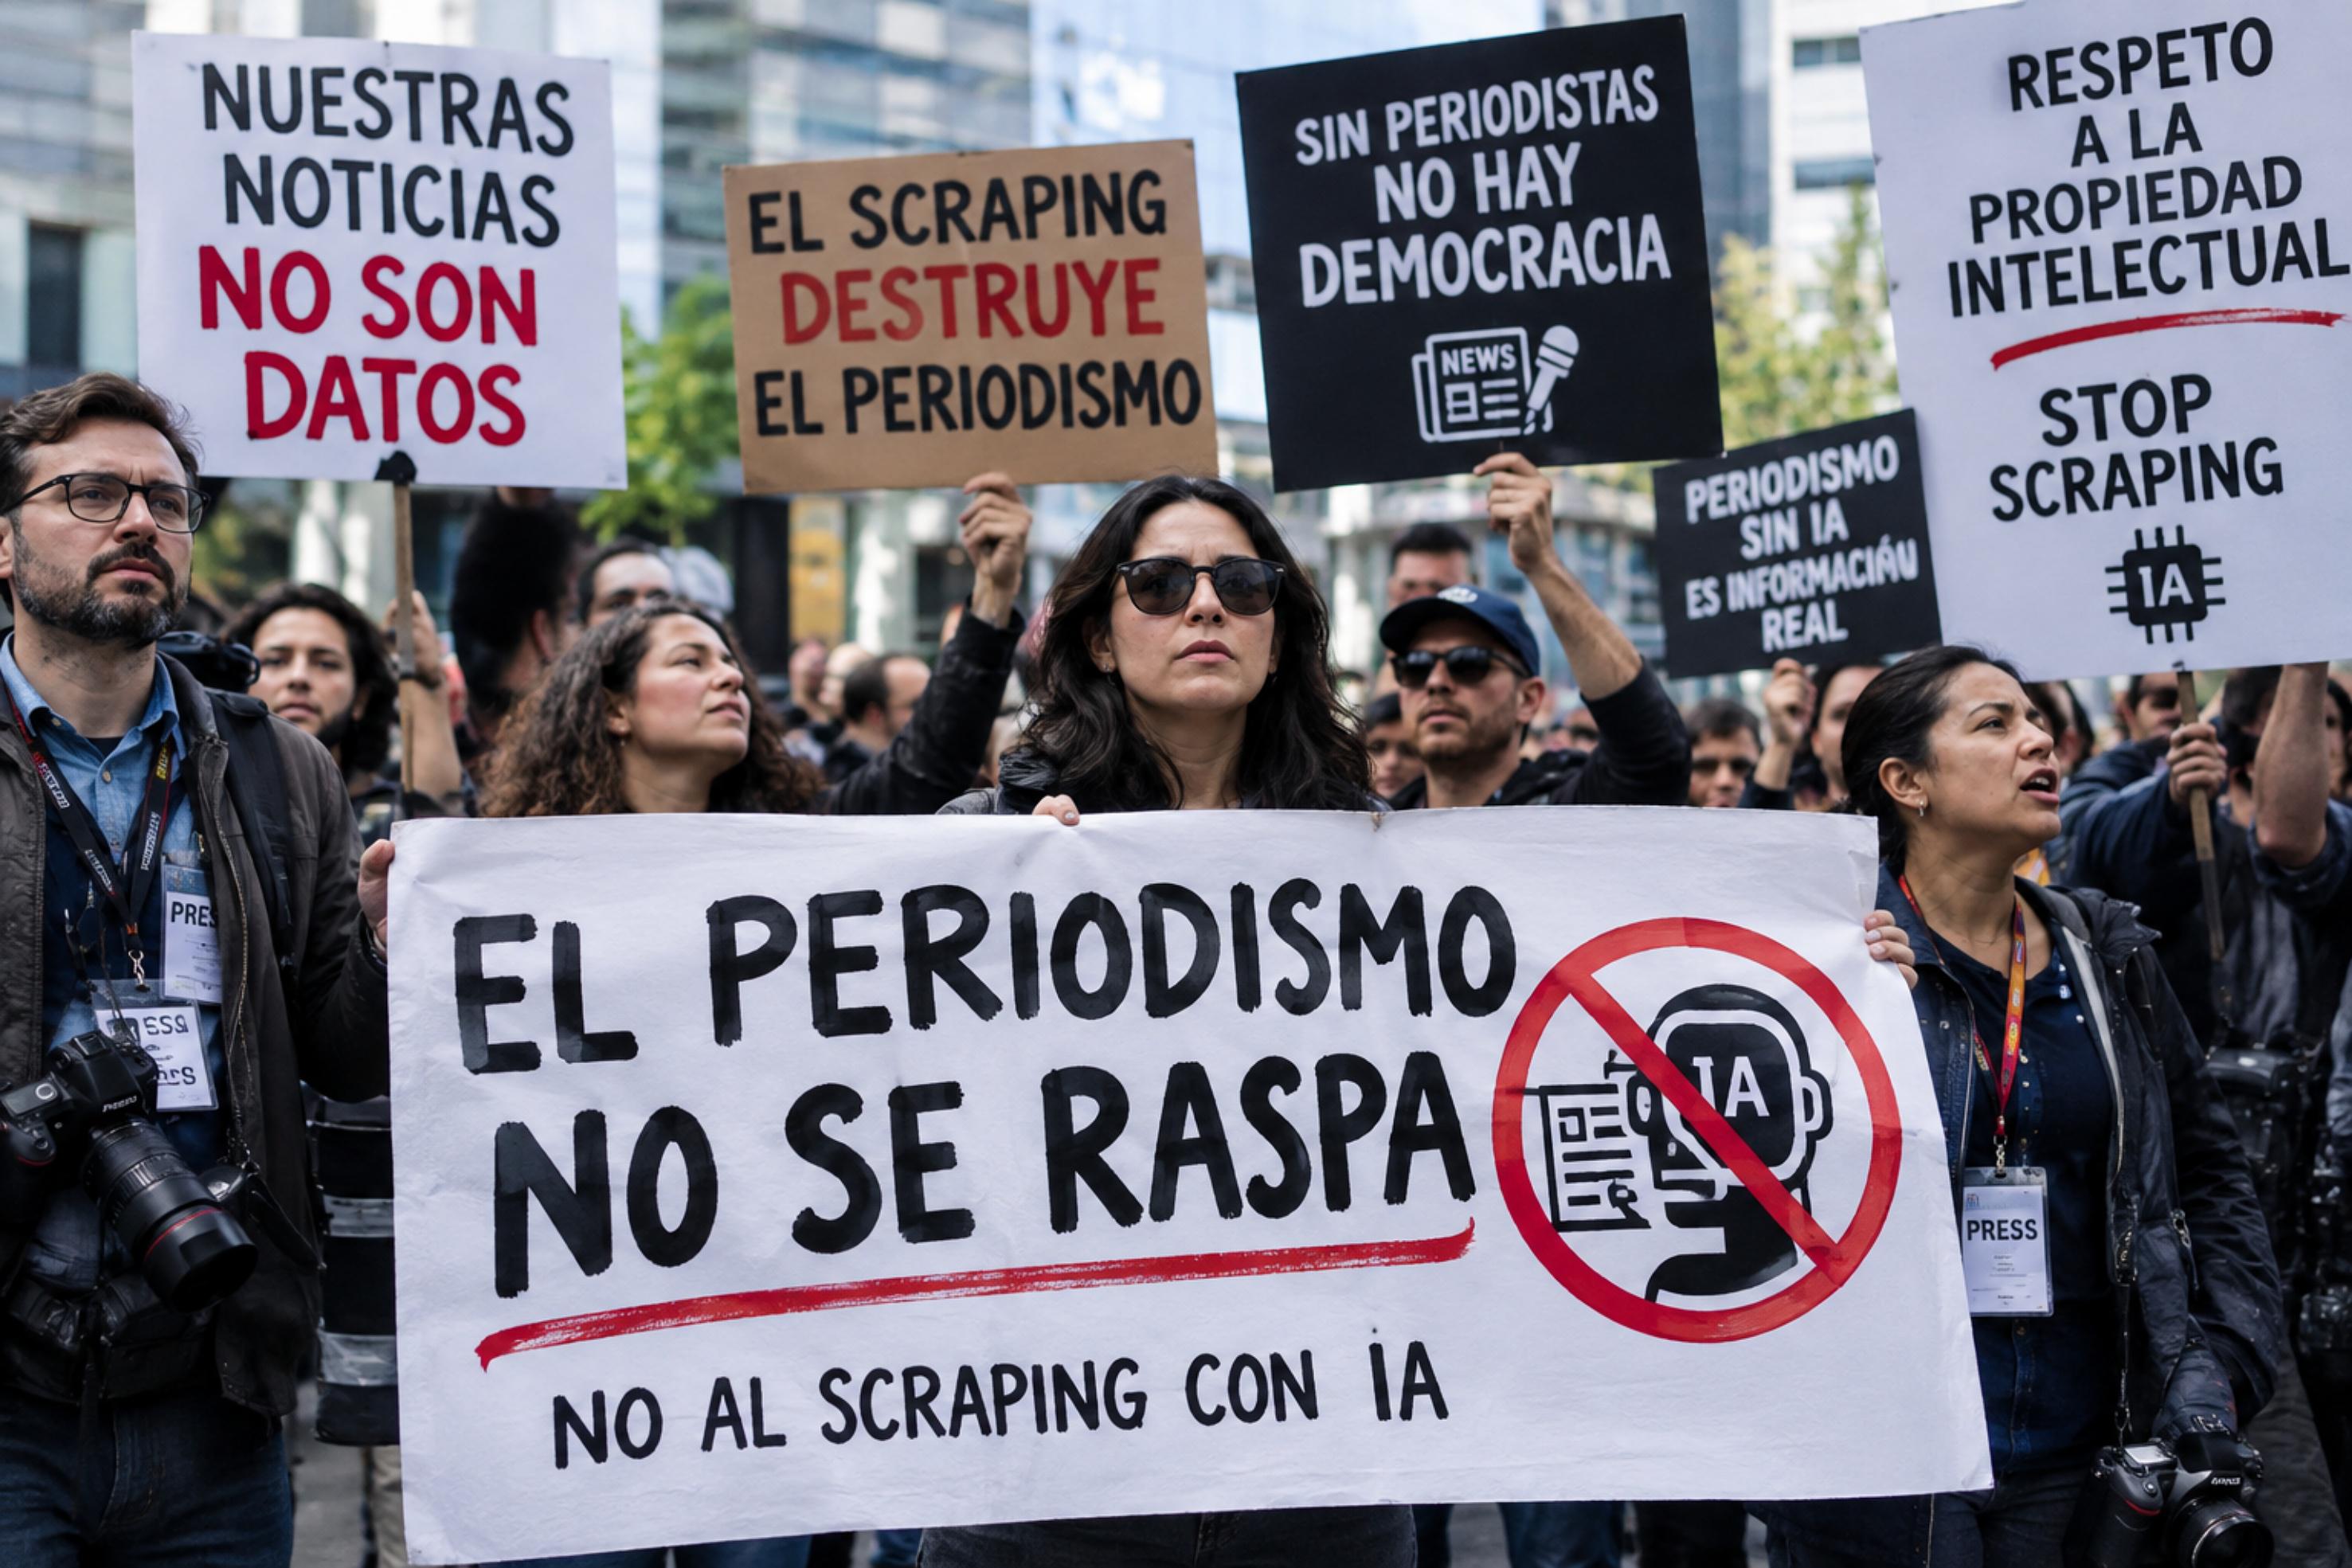
BUENOS AIRES- En tan solo unos pocos años, herramientas de IA como ChatGPT y Claude se han convertido en una tecnología generalizada. Las empresas que están detrás de estos productos innovadores alaban sus inmensos beneficios potenciales para la humanidad. Pero este discurso, aunque no es necesariamente erróneo, pasa por alto que estos modelos se basan en el robo generalizado de obras protegidas por derechos de autor y amenazan con debilitar aún más un pilar de la democracia ya de por sí frágil: el periodismo.
Por eso, Editorial Perfil, una importante editorial latinoamericana con sede en Argentina (y propietaria de Perfil, el periódico en el que soy director digital), ha demandado recientemente a OpenAI, propietaria de ChatGPT, y a Microsoft, el mayor accionista externo de la empresa, por el uso indebido del contenido periodístico de Editorial Perfil en sus productos de IA. En la demanda por daños y perjuicios presentada ante el Tribunal Federal Civil y Comercial de Argentina, también hemos acusado a estas empresas de “competencia desleal”; en otras palabras, de abusar de su posición oligopolística en nuestro perjuicio.
Aunque Editorial Perfil es la primera editorial en lengua española en presentar una demanda por infracción de derechos de autor contra una empresa de IA, sigue los pasos de The New York Times, que demandó a OpenAI y a Microsoft por el mismo motivo a finales de 2023. El periódico brasileño Folha de São Paulo presentó un caso similar en 2025, que finalmente culminó en un acuerdo de licencia de contenidos a principios de este año (un enfoque que OpenAI ha adoptado con otras editoriales, incluida PRISA, el conglomerado español propietario de El País).
Ya hemos pasado por esto antes: las plataformas dominantes de búsqueda y redes sociales también se beneficiaron de contenidos informativos protegidos por derechos de autor sin compartir siempre los beneficios. Los motores de búsqueda, como el modelo “gratuito” de Google, hicieron que los artículos periodísticos fueran mucho más accesibles al incluirlos en sus páginas de resultados. Pero, a pesar de depender en gran medida de este contenido protegido por derechos de autor para impulsar los ingresos publicitarios, Google no estaba obligado a proporcionar una compensación adecuada a las empresas de medios de comunicación que podrían emplear a cientos de periodistas para producirlo. Es cierto que estos sistemas de distribución dirigían el tráfico hacia los sitios web de los editores, pero el terreno de juego nunca fue equitativo y se inclinó cada vez más a favor de las empresas tecnológicas a medida que estas consolidaban su poder.
En la era de la IA, OpenAI y Anthropic (propietaria de Claude), así como los gigantes tecnológicos consolidados como Google y Meta (propietaria de Instagram y Facebook), han potenciado aún más esta dinámica. Los chatbots y otros productos empresariales de IA que han desarrollado a partir de modelos de lenguaje grandes y cada vez más sofisticados responden directamente a las preguntas de los usuarios de Internet, privando a los medios de comunicación del tráfico y de la oportunidad de mostrar anuncios o vender suscripciones a lectores potenciales.
Estos modelos requerían enormes cantidades de datos de entrenamiento, gran parte de los cuales eran material protegido por derechos de autor extraído ilegalmente de Internet. Anthropic ha llegado recientemente a un acuerdo en una demanda colectiva en California, en la que se comprometió a pagar 1,500 millones de dólares a autores de libros que alegaban que la empresa había descargado copias piratas de sus obras para entrenar a Claude. Y los modelos tienen una sed insaciable de más información, especialmente de datos actualizados sobre la actualidad.
En Editorial Perfil, hemos identificado múltiples casos en los que ChatGPT puede reproducir con detalle contenidos de nuestro archivo histórico. Hace lo mismo con las noticias en tiempo real e incluso anima a los usuarios a solicitar un resumen diario de noticias para que no pierdan tiempo visitando múltiples sitios web. Elude fácilmente los muros de pago; en el caso de los artículos que no encuentra en los propios sitios web de Editorial Perfil, recurre a sitios web imitadores que los han reproducido ilegalmente. Los datos históricos de los servidores muestran que múltiples bots rastrean constantemente nuestro contenido, no solo los de OpenAI, sino también los de todas las empresas de IA.
Estos abusos flagrantes son evidentes para cualquiera con sentido común. Las empresas de IA no solo están robando contenido, sino que también animan a los usuarios a permanecer dentro de sus ecosistemas cerrados, convirtiendo Internet en un mercado oligopolístico. Sin embargo, siguen intentando argumentar que están haciendo un “uso legítimo” de contenido “disponible públicamente”. Por desgracia para OpenAI, ya ha reconocido el valor del periodismo a través de sus numerosos acuerdos de licencia. Por el contrario, Anthropic ha evitado los acuerdos de licencia de contenidos con los medios de comunicación.
El sector de la información lleva en crisis desde que la revolución digital trastocó su modelo de negocio hace más de dos décadas. Nunca surgió un modelo nuevo y más sostenible. Aunque los que trabajamos en los medios de comunicación no supimos anticipar cómo el auge de Internet lo cambiaría todo, intentamos reinventarnos a posteriori. Pero el dominio oligopolístico de las grandes tecnológicas nos ha impedido lograr avances reales, y la IA está agravando la crisis.
Una industria de la información diezmada es un mal resultado para todos. No solo daría lugar a un público menos informado, sino que también perjudicaría a las propias empresas de IA parasitarias, privándolas de una importante fuente de datos de entrenamiento. Si no se molestan en actuar en interés del público, al menos deberían velar por el suyo propio. Copyright: Project Syndicate, 2026.
Agustino Fontevecchia es director digital de Perfil en Argentina.